第 4 阶段 动态
课程稿 v0.1 | 45~90 分钟 | 对应洛书灵枢 v1.0.19
这一阶段把第 1 集的镜头图,逐镜变成 5~15 秒的视频片段。用画布的
AI 视频节点,图生视频为主,首尾帧接镜,最后把片段收进素材库「视频片段」。
本阶段做完,你手里应该有
- 第 1 集每个镜头一条视频片段,单条 5~15 秒;
- 全部 9:16 竖屏;
- 镜头之间接得上:上一镜的尾帧接下一镜的首帧,或同一条片段内完成动作;
- 每条片段都在
短剧0到1-练习项目的素材库「视频片段」里; - 至少一条用首尾帧做的转场。
开始前
- 第 3 阶段做完:第 1 集至少 8 张 9:16 镜头图;
- 镜头图能在素材库
控制图或画布结果图片找到; - 知道视频生成是本课花费最大的一段;课程不承诺零成本;
- 45~90 分钟。
视频生成按秒计费,先想清楚再点。第一遍用 5 秒、720p、关音频做草稿;满意后再考虑重生成或加长。
4.1 建 AI 视频节点,把镜头图接进去
- 画布空白处双击 →
视频→AI 视频;或从镜头图的输出口拖线到空白处,菜单里选AI 视频(自动连好线)。 - 把镜头图(
结果图片或上传图片节点)的输出口,拉到 AI 视频节点左侧输入口。 - 只连 1 张图:这是图生视频,图就是第一帧。
- 连 2 张图:自动变首尾帧,第 1 张首帧、第 2 张尾帧——恰好 2 张,多一张少一张都会被拦。
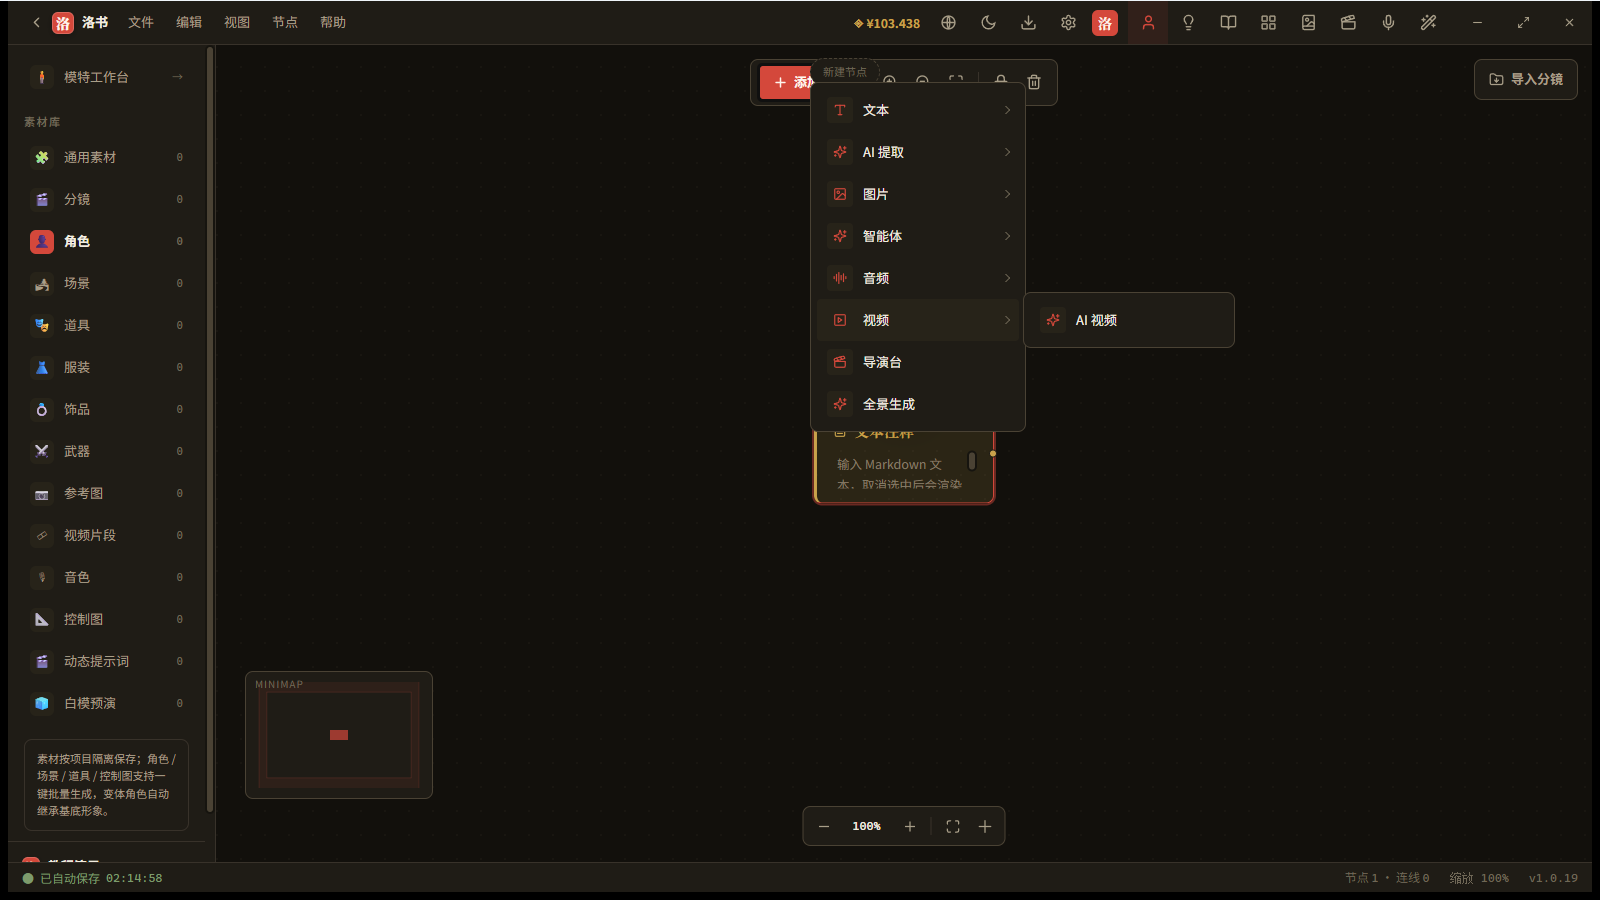
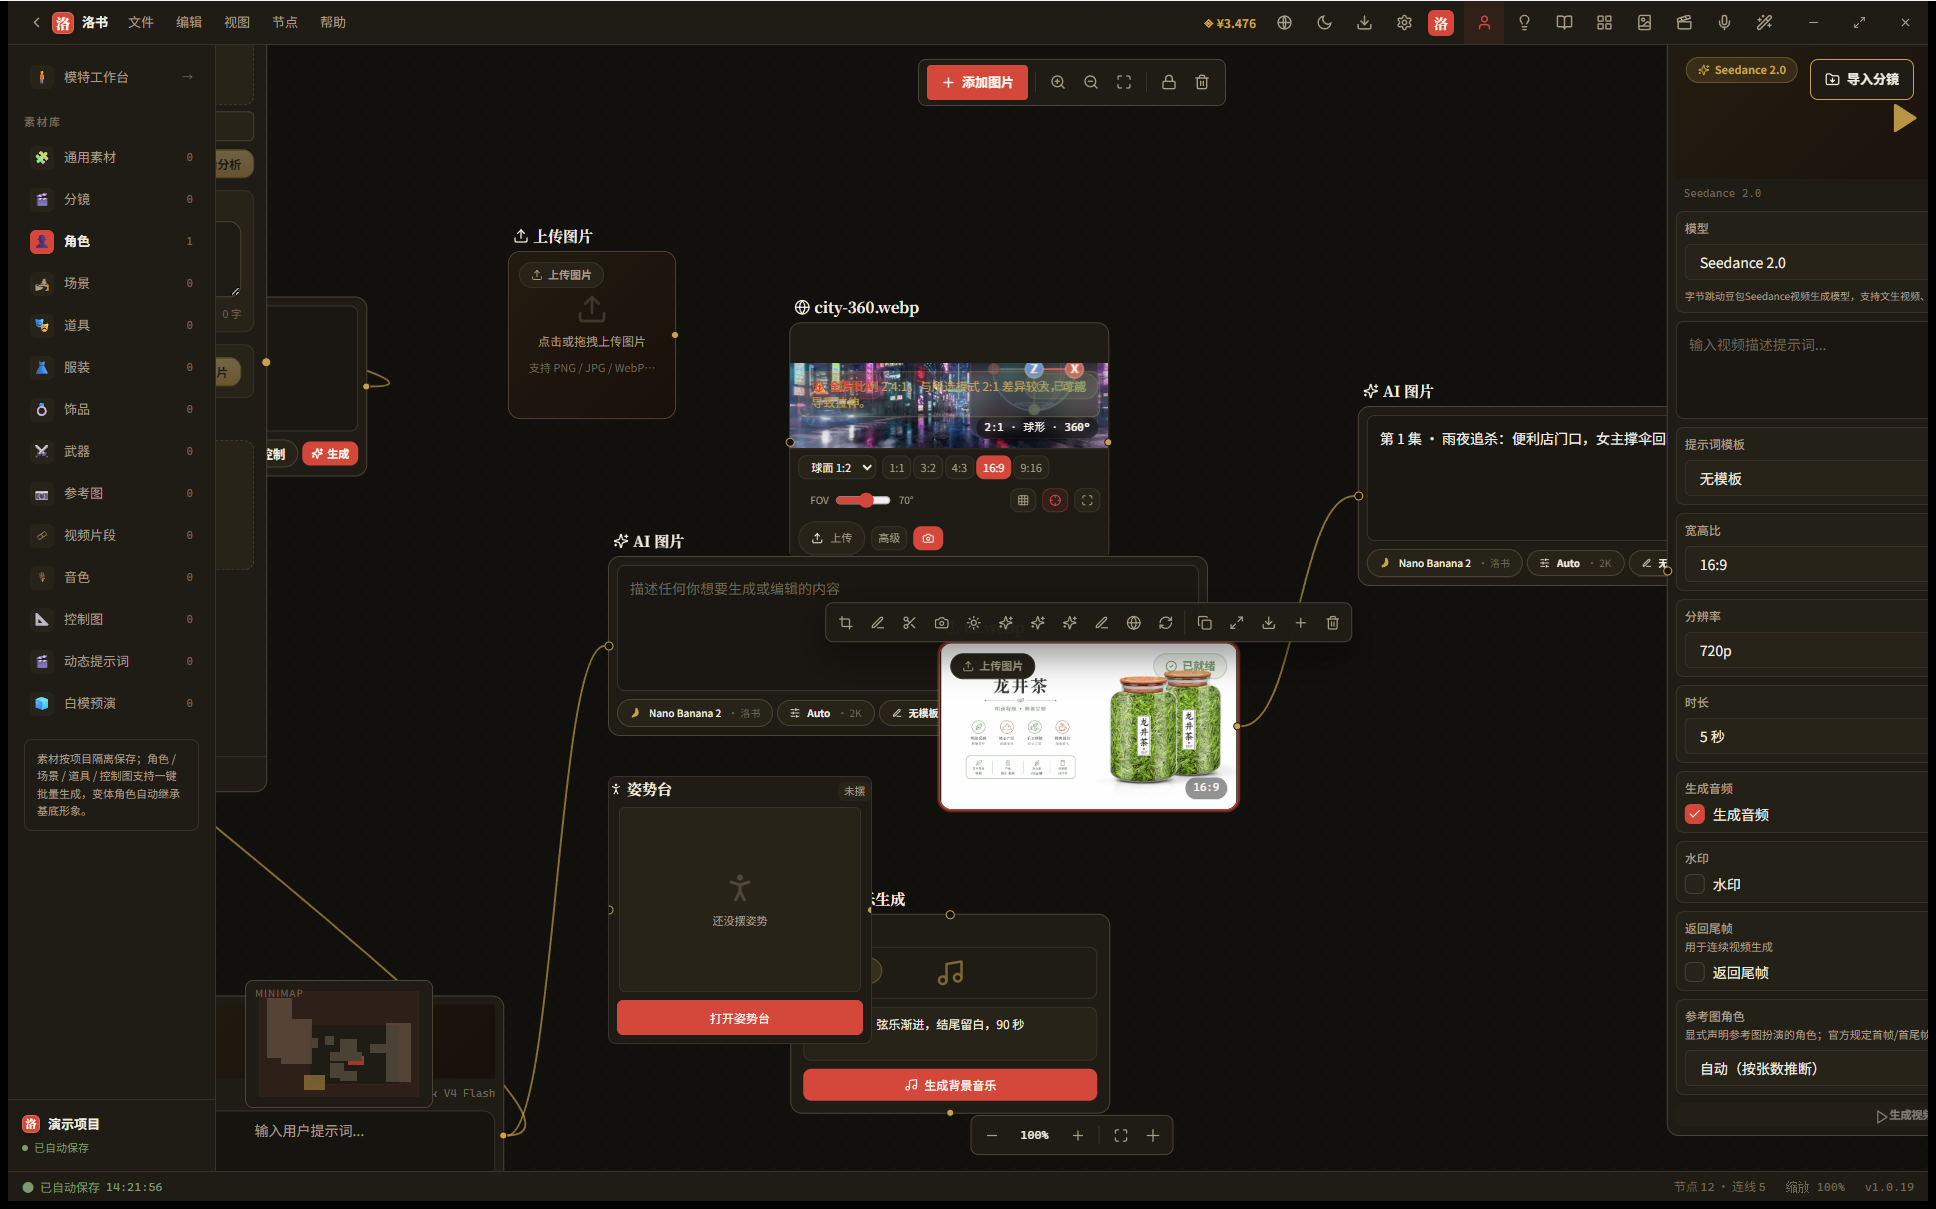
检查点:AI 视频节点建好,镜头图连在输入口;节点上能看到参考图缩略图。
4.2 选模型、定参数
节点从上到下:
| 参数 | 本课怎么选 | 说明 |
|---|---|---|
模型 |
Seedance 2.0(默认) |
第一遍用它;Fast/mini 更快更便宜,2.5 支持 30 秒 |
宽高比 |
9:16 |
竖屏短剧;默认 16:9,必须改 |
分辨率 |
720p |
草稿可 480p;1080p/4K 更贵 |
时长 |
5 秒 |
单镜 5 秒起步;2.5 最长 30 秒 |
生成音频 |
关 | 我们第 5 阶段用配音台单独配音;开着会多一份音频,后期还要处理 |
水印 |
关 | — |
返回尾帧 |
开 | 出片时自动多一个上传图片节点装尾帧,接下一镜首帧 |
参考图角色 |
自动 | 按张数推断;首尾帧要显式控制时再改 |
换模型会把分辨率、比例、时长、额外参数全部重置——先选模型,再调参数。
检查点:模型、9:16、720p、5 秒、生成音频关、返回尾帧开。
4.3 写提示词:只写“动什么、怎么动”
提示词框占位 输入视频描述提示词...。不要重复描述静态画面(镜头图已经给了),只写运动:
镜头缓慢推近。雨滴打在手机屏幕上,屏幕的光映在林默脸上。他的手指发抖,慢慢按下接听键。背景霓虹在湿漉漉的楼道墙上晃动。手持感,轻微呼吸式晃动。
写运动的三件事:
| 写什么 | 例子 |
|---|---|
| 镜头怎么动 | 缓慢推近 / 从下往上摇 / 跟随背影 / 固定机位 |
| 主体怎么动 | 手指发抖 / 转头 / 后退半步 / 把手机举到耳边 |
| 环境怎么动 | 雨滴落下 / 霓虹闪烁 / 楼道灯忽明忽暗 |
有多个参考图时,在提示词里打 @ 插入 @图片1、@图片2 指认;不写就按连线顺序。
检查点:每条提示词都能看出“镜头 + 主体 + 环境”三种运动。
4.4 生成、看结果、接下一镜
- 点
生成视频。按钮变生成中...且不可再点(防连点重复扣费)。 - 画布右侧自动出现
结果视频节点,状态生成中;等待文案依次是上传媒体素材中...→等待服务器生成 (任务ID: ...)→仍在生成中...已等待 N 分钟。 - 完成后状态
已回流,封面显示尾帧(开了返回尾帧才有,脚注尾帧✓)或抽帧封面。 - 点播放按钮试看;不满意改提示词,点
重新生成(有二次确认)。 - 下一条镜头:把上一条的尾帧(自动生成的上传图片节点)连到新的 AI 视频节点,当首帧。这样上一镜的落幅就是下一镜的起幅,接得上。
首尾帧转场:想从 A 画面过渡到 B 画面,连恰好 2 张图——第 1 张首帧、第 2 张尾帧,提示词写“从 A 平滑过渡到 B”。
检查点:至少 3 条片段接上了尾帧→首帧;没有明显跳变。
4.5 五种输入形态,本课只用两种
| 形态 | 怎么用 | 本课 |
|---|---|---|
| 文生视频 | 不连图,纯提示词 | 不用(角色会不稳定) |
| 图生视频 | 1 张图当首帧 | 主路 |
| 首尾帧 | 恰好 2 张图 | 转场用 |
| 多模态参考 | 多图/图+音频 | 进阶,先不碰 |
| 五段流 | 1~5 段、每段 5~15 秒、自动合成总片 | 进阶,贵;本课不用 |
五段流是镜像模型 MiniMax H3 五段流,跑在你自己的 AutoDL 实例上,约 3 分钟/段,5 段约 15 分钟 GPU 起。第一次做短剧,不要用它;先把逐镜图生视频跑通。
4.6 把片段收进素材库
每条结果视频:
- 选中
结果视频节点; - 顶部工具条点
添加到片段库(不在卡片里); - 弹窗
新建视频片段:填片段名称(建议第1集-镜01)、描述; - 保存后进素材库
视频片段分类。
也可以直接点结果节点底部 下载,存到系统下载目录。片段库和下载目录各留一份,后面剪辑用。
视频:第 10 集 生成的东西去哪了(2:46):结果节点、下载、素材库回流。视频生成的结果节点同理。打不开就点这里。
检查点:素材库 视频片段 里能看到第 1 集的所有片段,命名按镜号排好。
4.7 本阶段检查点
全部打勾,再进第 5 阶段:
- 第 1 集每个镜头至少一条视频片段;
- 每条 5~15 秒,9:16;
- 角色没有明显变脸、变形;
- 至少 3 条用尾帧→首帧接上;
- 至少 1 条首尾帧转场;
- 所有片段都在素材库
视频片段,命名能对上镜号; - 没有明显黑屏、卡帧、闪烁。
证据:截两张图——结果视频节点(带尾帧✓)、素材库视频片段列表;记下第 1 集片段总数。
4.8 常见坑
- 换模型后参数全变了:换模型会重置比例/分辨率/时长/额外参数;先选模型再调参数。
- 首尾帧多一张少一张:首尾帧恰好 2 张,硬约束;多一张少一张都会被拦。
- 参考图超上限:卡片底部
N/上限,超限转红;生成前硬拦。 - 提示词空点生成:按钮置灰;先写提示词。
- 连点生成:生成中按钮禁用,连点会重复扣费;等结果节点状态。
- 进度条满格还没出片:进度条是按预计耗时的估算,封顶 96%;以结果节点状态为准。
- 结果节点只有下载、没有片段库:
添加到片段库在选中节点后的顶部工具条,不在卡片里。 - 一直转到 60 分钟:任务过期/取消会报
视频任务已过期/取消,请重新生成;连续查询失败 6 次会提前报错。 - 想重问结果又怕花钱:带任务 ID 的结果节点点
重新获取,只重问、不重新生成、不扣费。 - 五段流很贵:约 3 分钟/段,5 段约 15 分钟 GPU 起;先用 1~2 段试水。
- 生成音频开着:第 5 阶段会单独配音,视频自带的音频会重复;本课关掉。
- 片段命名乱:按
第1集-镜01这种命名,第 6 阶段剪辑时不用猜顺序。
4.9 下一步
第 5 阶段 声音:用配音台给第 1 集配音,铸角色音色,逐句合成,导出 WAV + 台词表 + SRT。
进第 5 阶段前,你手里必须有:第 1 集全部视频片段(或至少每个镜头一条)、镜头顺序表、角色名。
下一课:第 5 阶段 声音